Z-Image Base: La Fondamenta S3-DiT da 6B per Massimo Fotorealismo e LoRA
Scopri il checkpoint foundation non distillato da 6 miliardi di parametri alla base dell'ecosistema Z-Image di Alibaba Tongyi-MAI. Progettato per il pieno controllo Classifier-Free Guidance (CFG), precisione coi prompt negativi, texture da galleria d'arte e addestramento personalizzato di LoRA e ControlNet.
Area di gioco immagini AI Ultra-HD
Genera immagini 4K ad alta fedeltà con istruzioni di livello professionale e rendering fulmineo.
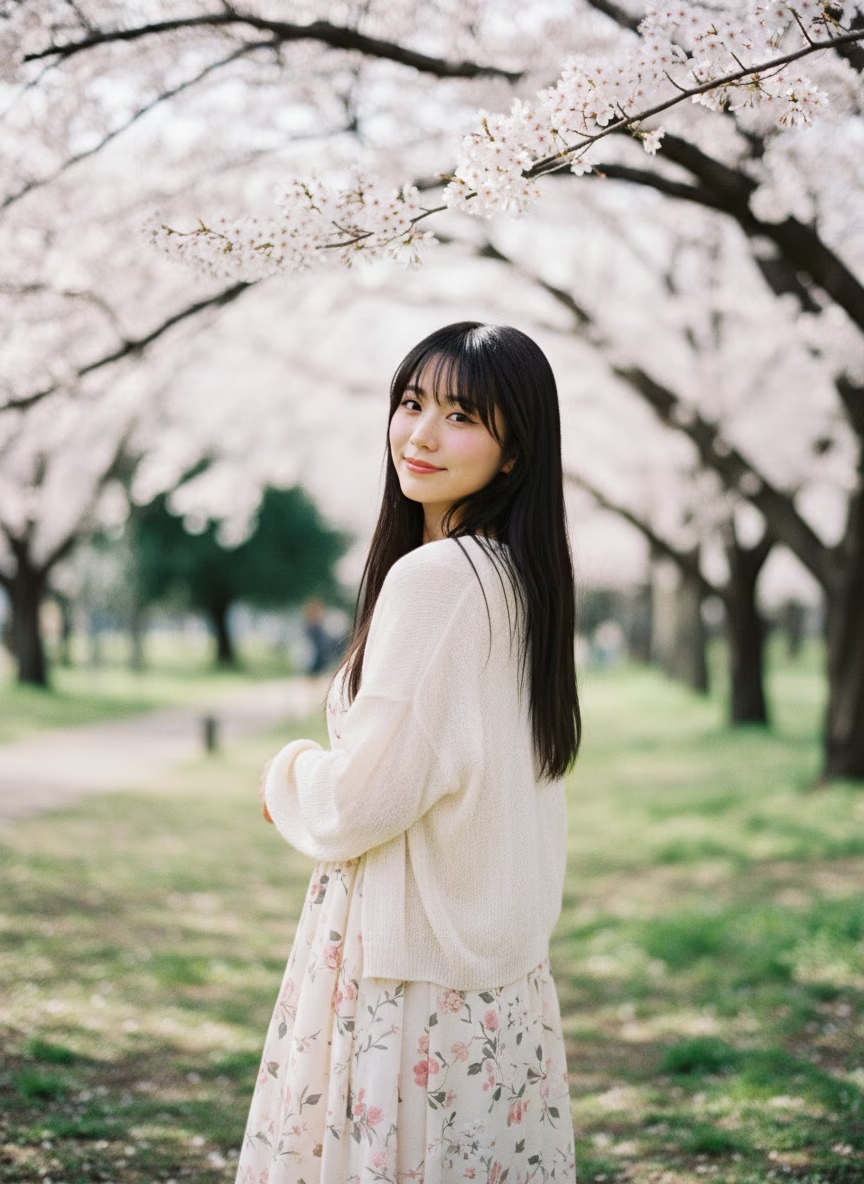
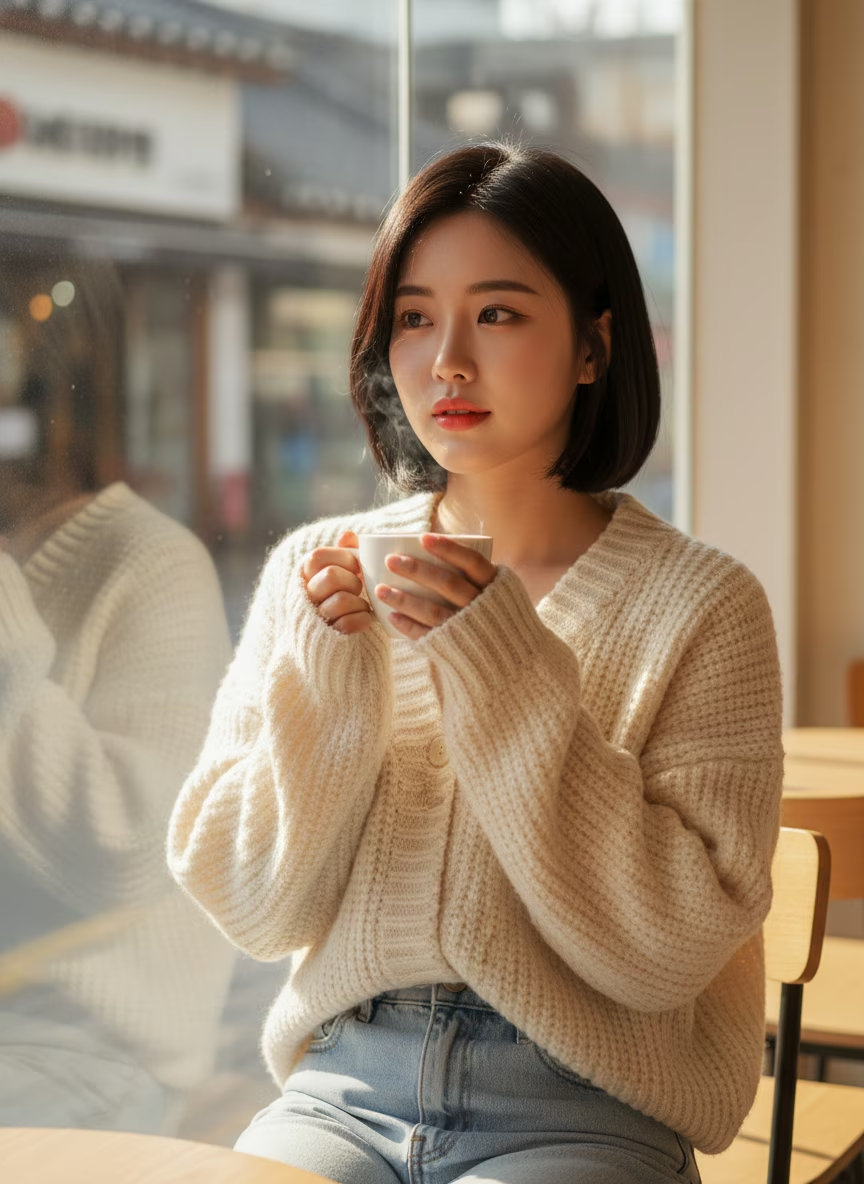
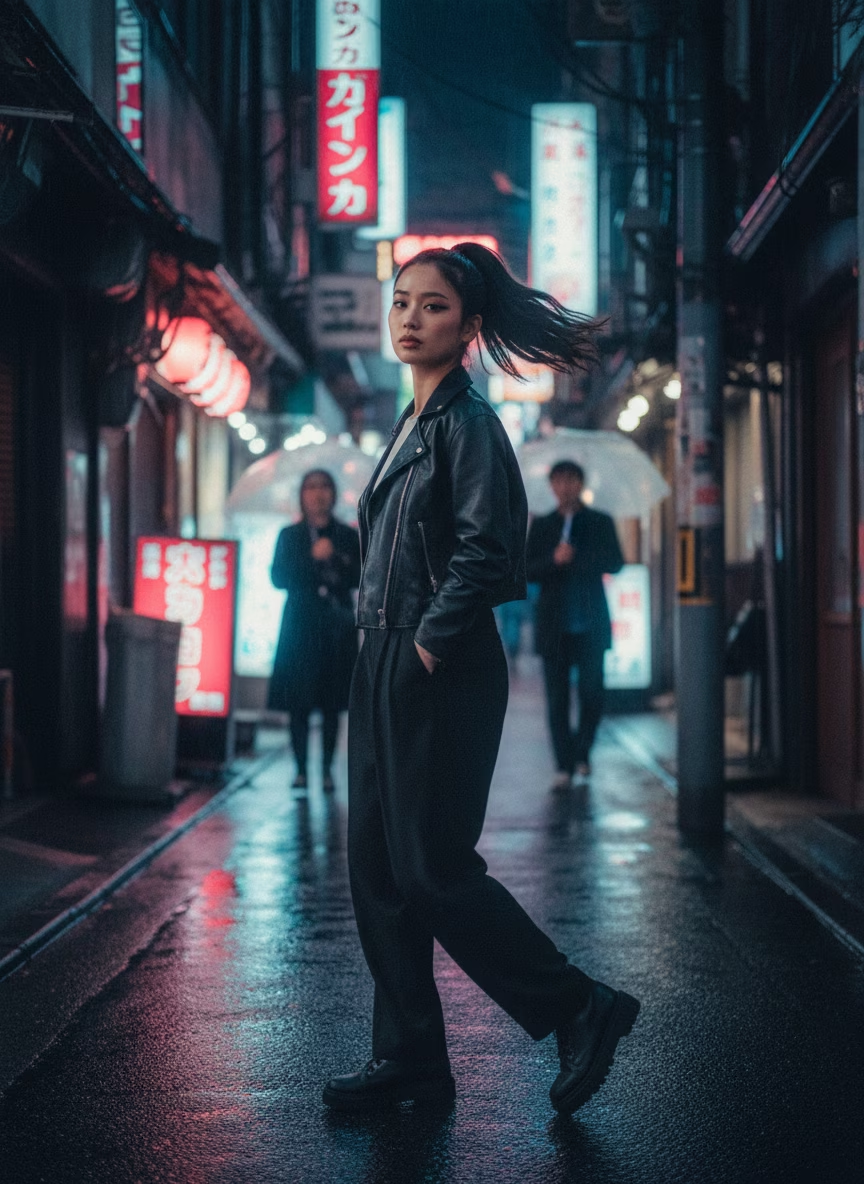
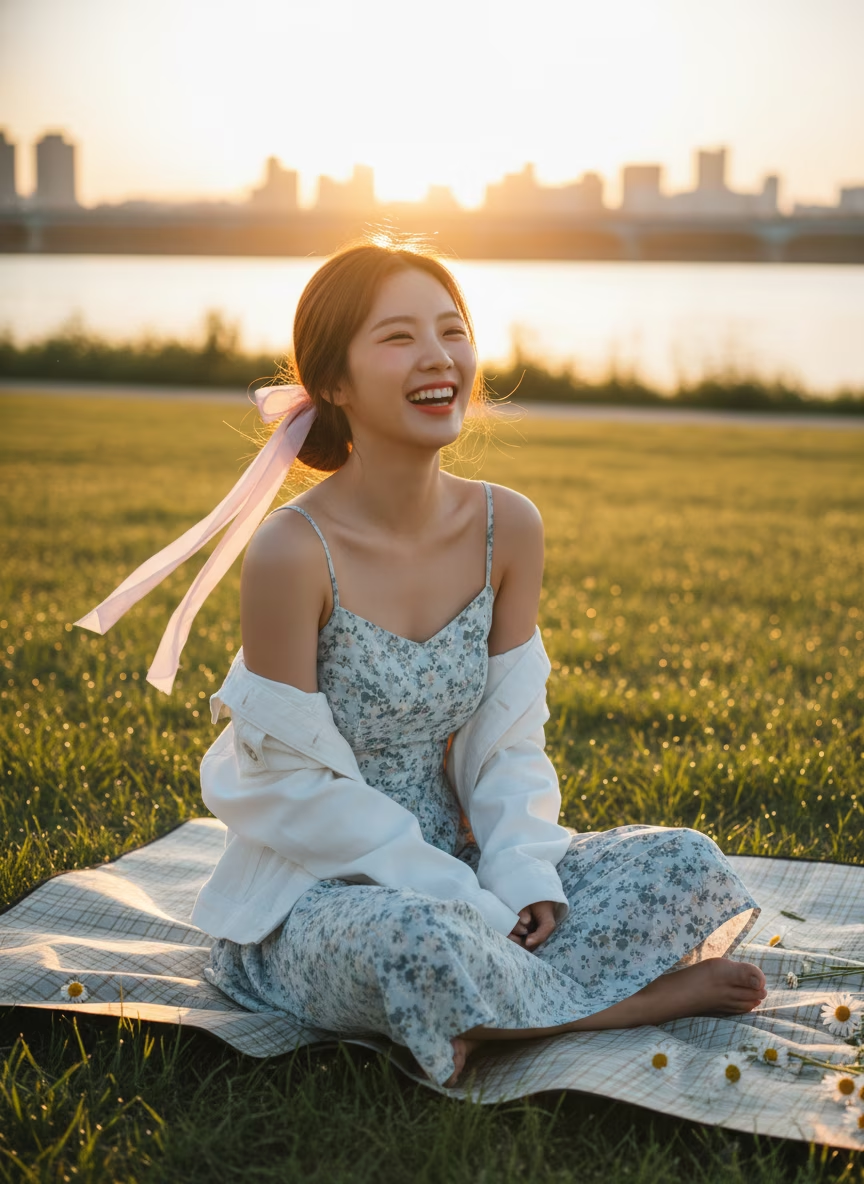


Perché Z-Image Base è Fondamentale per Creativi e Sviluppatori
Mentre Z-Image Turbo domina la generazione sub-secondo in 8 step, i modelli distillati comprimono la varietà latente e rendono più complesso l'addestramento di LoRA a valle. Alibaba Tongyi-MAI ha rilasciato il checkpoint non distillato Z-Image Base (Tongyi-MAI/Z-Image) proprio per sbloccare l'intera diversità del denoising multi-step, la regolazione granulare di Classifier-Free Guidance (CFG), il controllo tramite prompt negativi e una convergenza pulita in fase di fine-tuning.
Massima Varietà Creativa
Senza la compressione modale della distillazione a pochi step, Z-Image Base genera composizioni molto più variegate al cambiare del seed: ideale per art direction, alta moda e concept design.
Pieno Controllo CFG e Prompt Negativi
Supporta il campionamento multi-step classico (tipicamente 28–50 NFE con CFG 3.5–5.0), permettendo di scolpire la luce, eliminare artefatti indesiderati e bilanciare con esattezza lo stile.
Nato per Addestrare LoRA e ControlNet
Con gradienti non distillati, l'addestramento di LoRA per personaggi, adattatori di coerenza prodotto e ControlNet su Z-Image Base da 6B converge più rapidamente e richiede la metà della memoria rispetto ai 12B di FLUX.1-dev.
Fondamenta Semantica Bilingue
Condivide lo stesso flusso unificato di token testo-immagine in inglese e cinese, consentendo di addestrare checkpoint verticali per tipografia di brand, architettura, anime ed e-commerce.
Quando Scegliere Z-Image Base rispetto a Z-Image Turbo
Comprendere come Z-Image Base e Z-Image Turbo si completano a vicenda aiuta gli studi creativi a usare lo strumento giusto in ogni fase della produzione.
Come Prototipare Flussi Z-Image su z-img.net
Unisci l'ideazione istantanea nel cloud al prompt engineering di livello professionale:
1. Accedi al Tuo Studio Cloud
Effettua l'accesso su z-img.net da qualsiasi browser per ricevere crediti iniziali gratuiti e testare prompt su Z-Image senza dover scaricare prima oltre 12 GB di file safetensors.
2. Prova Prompt e Template Curati
Carica template collaudati di ritratti, architettura e tipografia inglese/bilingue per studiare come S3-DiT risponde a parametri fotografici, luci e testo tra virgolette.
3. Esporta Render 4K o Scala in Locale
Scarica immagini ad alta risoluzione pronte all'uso direttamente dal cloud, oppure segui la documentazione per configurare pipeline locali Z-Image Base + LoRA.
Punti di Forza Architetturali di Z-Image Base
Progettato da Alibaba Tongyi Lab per estensibilità open-source e affidabilità commerciale.
Single-Stream DiT da 6B (S3-DiT)
Concatena token testuali, semantici visivi e VAE in un unico stream transformer unificato per la massima efficienza dei parametri.
Supporto Nativo ai Prompt Negativi
La Classifier-Free Guidance completa permette di allontanarsi esplicitamente da stili indesiderati, dominanti cromatiche o difetti anatomici.
Metà dell'Impronta di FLUX.1-dev
6 miliardi di parametri contro 12 miliardi riducono drasticamente il consumo di VRAM e i tempi di training LoRA su GPU da 16 GB–24 GB.
Allineamento Token Inglese e Cinese
Comprensione semantica di primo livello e rendering nitido di scritte in inglese e cinese per team creativi internazionali.
Nativo su ComfyUI e Diffusers
Supportato immediatamente in Hugging Face Diffusers, ModelScope e nei nodi standard di ComfyUI.
Licenza Permissiva Apache 2.0
A differenza dei pesi dev non commerciali di altri laboratori, Z-Image consente fine-tuning e utilizzo commerciale senza restrizioni.
Specifiche Foundation di Z-Image Base
Specifiche tecniche chiave del checkpoint non distillato Z-Image da 6B.
6B Parametri Foundation S3-DiT Non Distillato
28–50 Step Precisione Denoising con CFG Completo
Apache 2.0 Pronto per Uso Commerciale e LoRA
Domande Frequenti su Z-Image Base
Differenze chiave tra Z-Image Base, Z-Image Turbo e FLUX.1-dev.