Z-Image Base: Το Θεμέλιο 6B S3-DiT για Κορυφαίο Φωτορεαλισμό & Εκπαίδευση LoRA
Γνωρίστε το μη αποσταγμένο θεμελιώδες checkpoint 6 δισεκατομμυρίων παραμέτρων πίσω από το οικοσύστημα Z-Image της Alibaba Tongyi-MAI. Σχεδιασμένο για πλήρη έλεγχο Classifier-Free Guidance (CFG), ακρίβεια στα negative prompts, υφές μουσειακής ποιότητας και προσαρμοσμένη εκπαίδευση LoRA & ControlNet.
Ultra-HD AI Πεδίο Δημιουργίας Εικόνων
Δημιουργήστε οπτικά εφέ 4K υψηλής πιστότητας με επαγγελματική καθοδήγηση και αστραπιαία ταχύτητα απόδοσης.
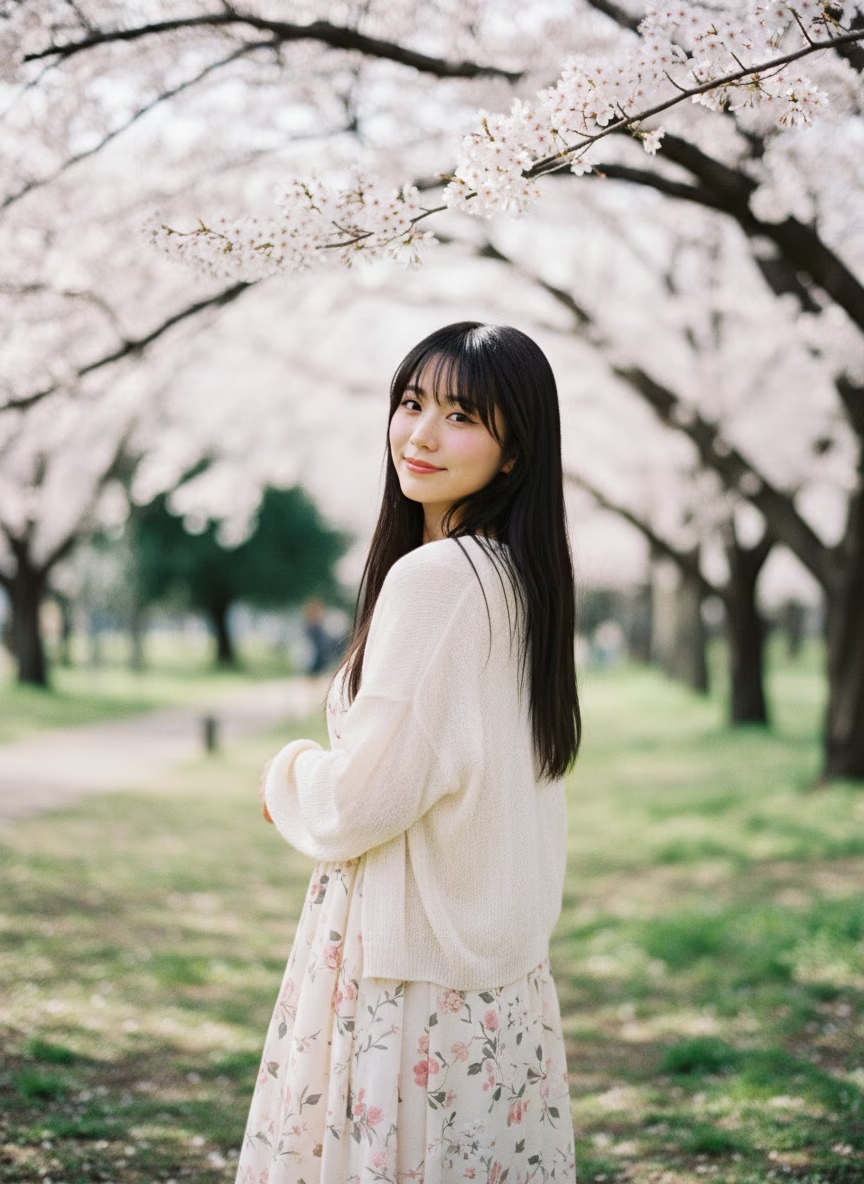
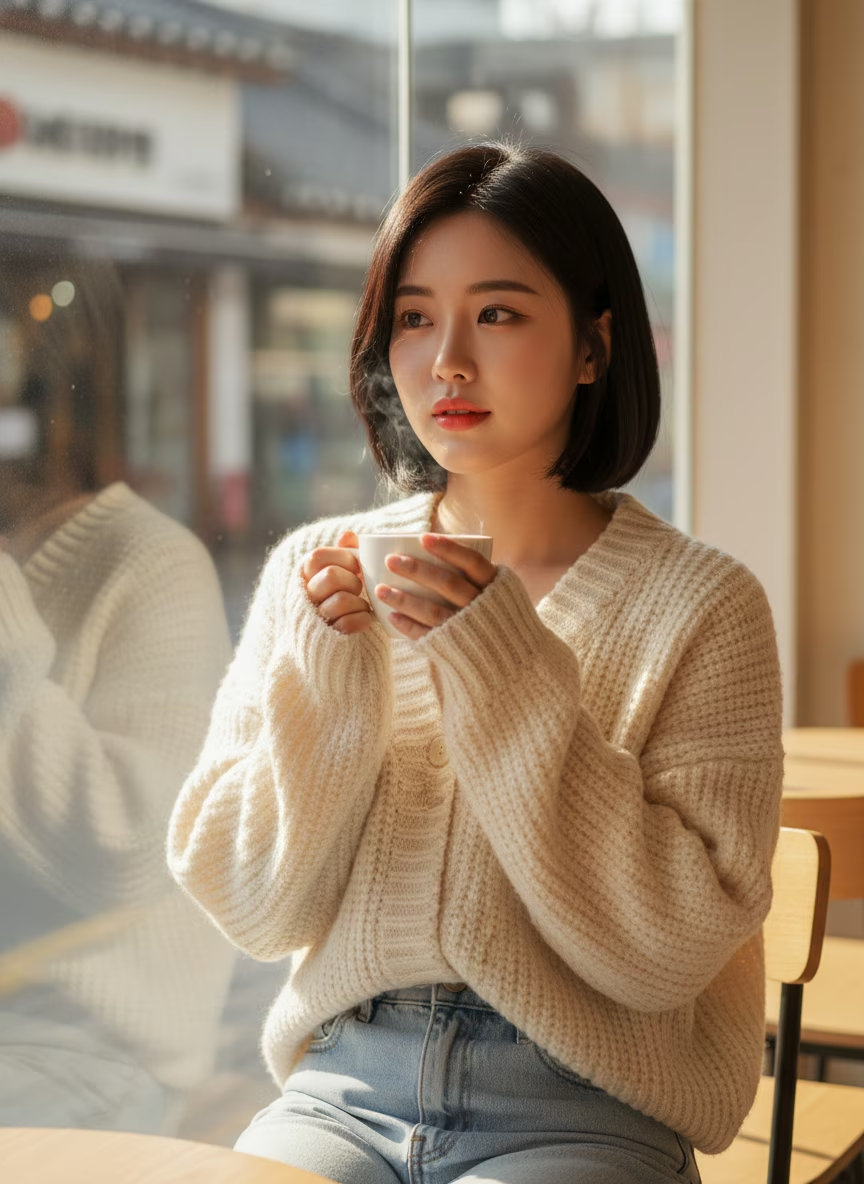
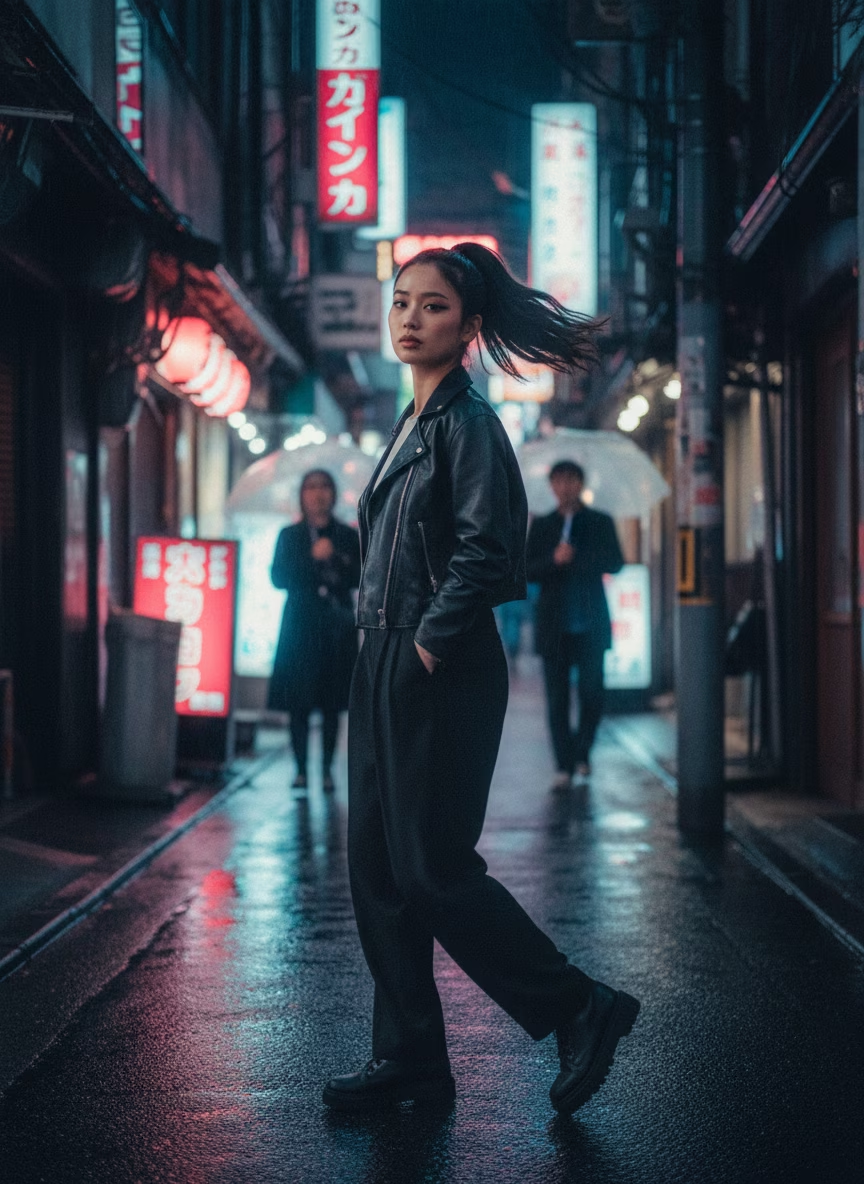
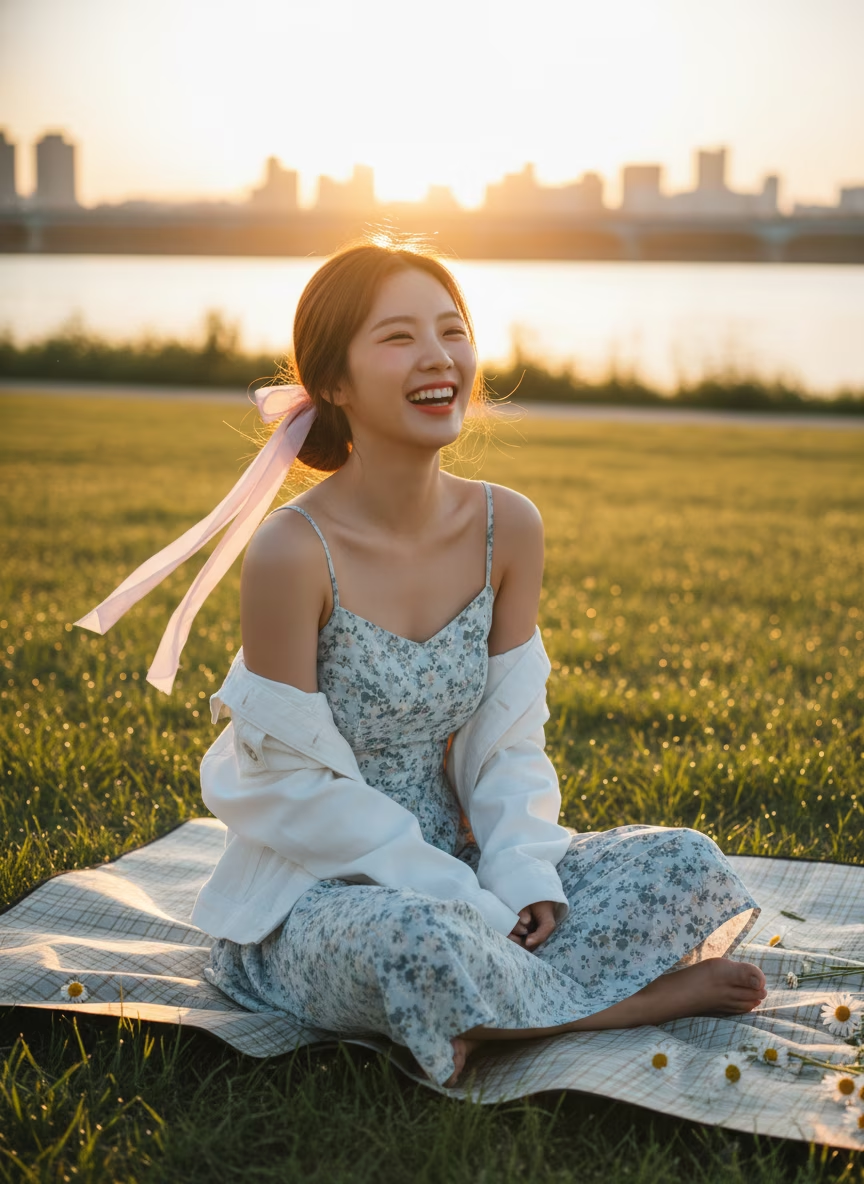
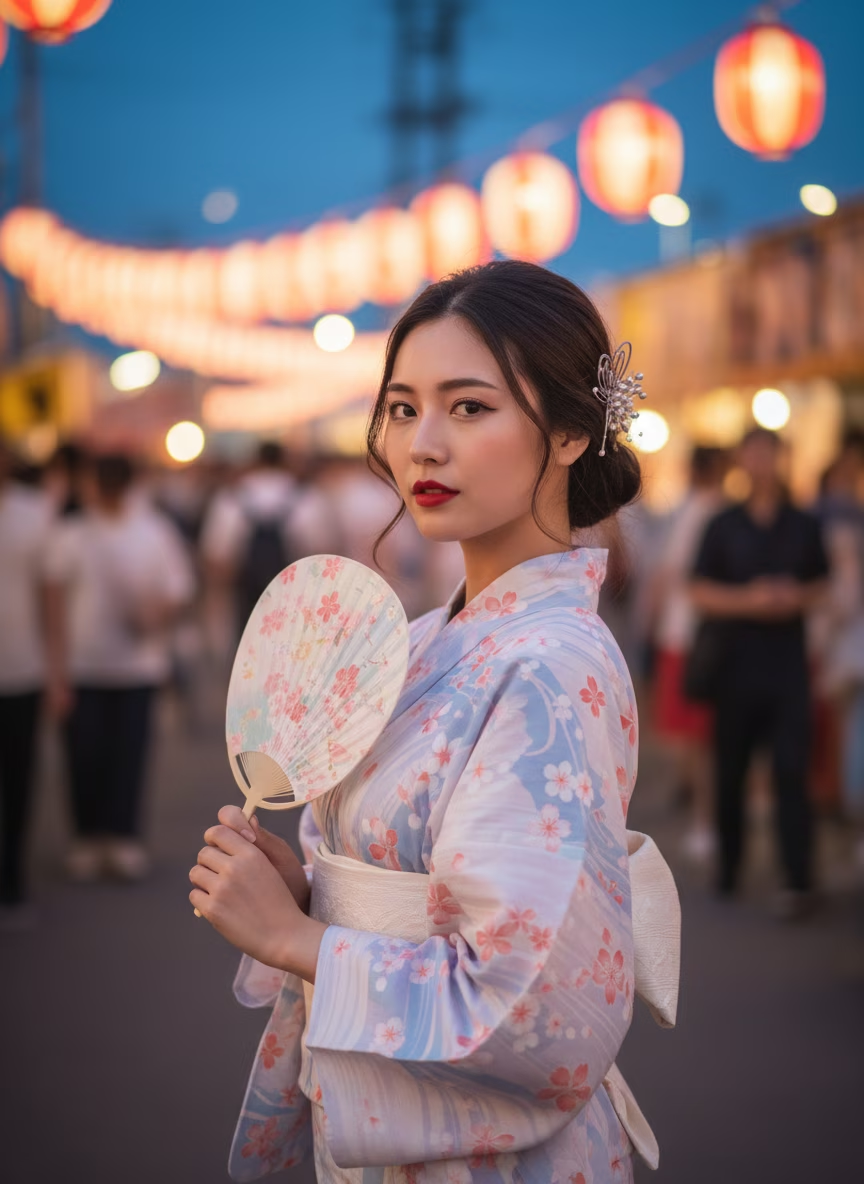
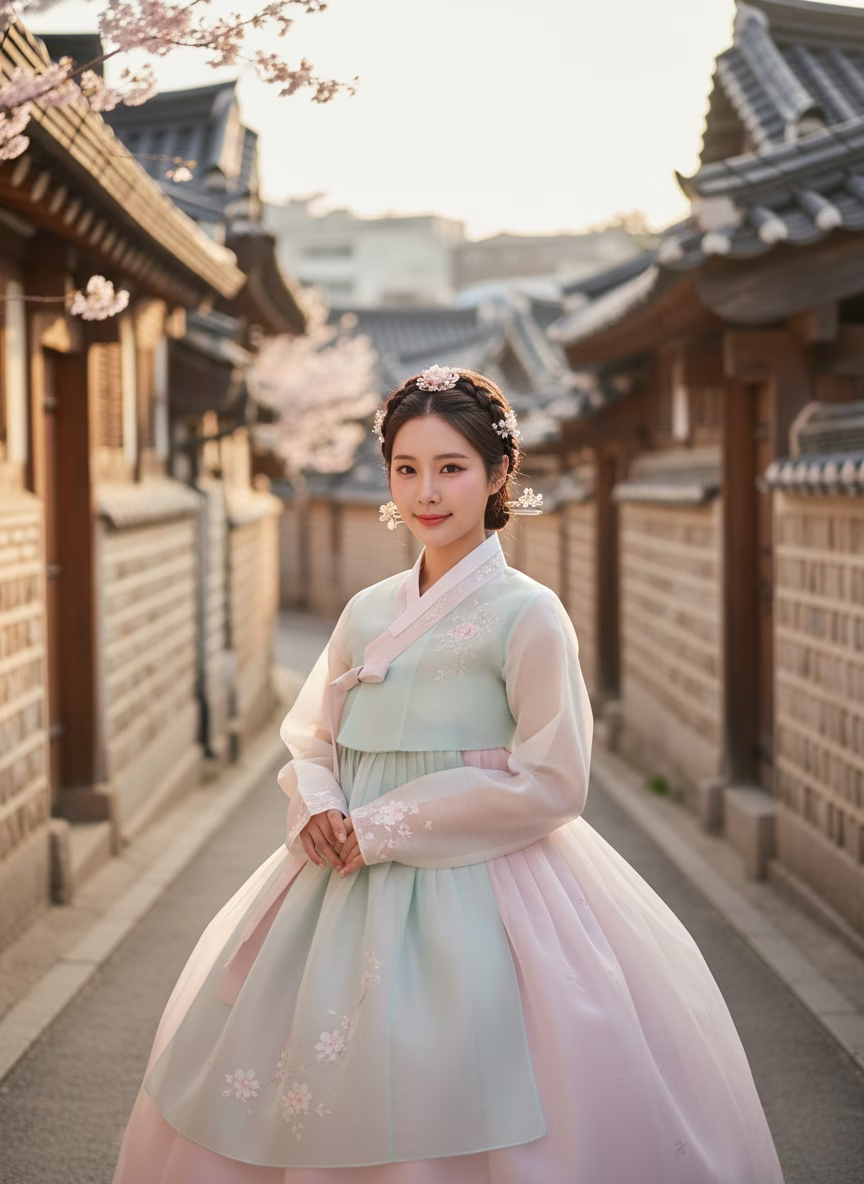
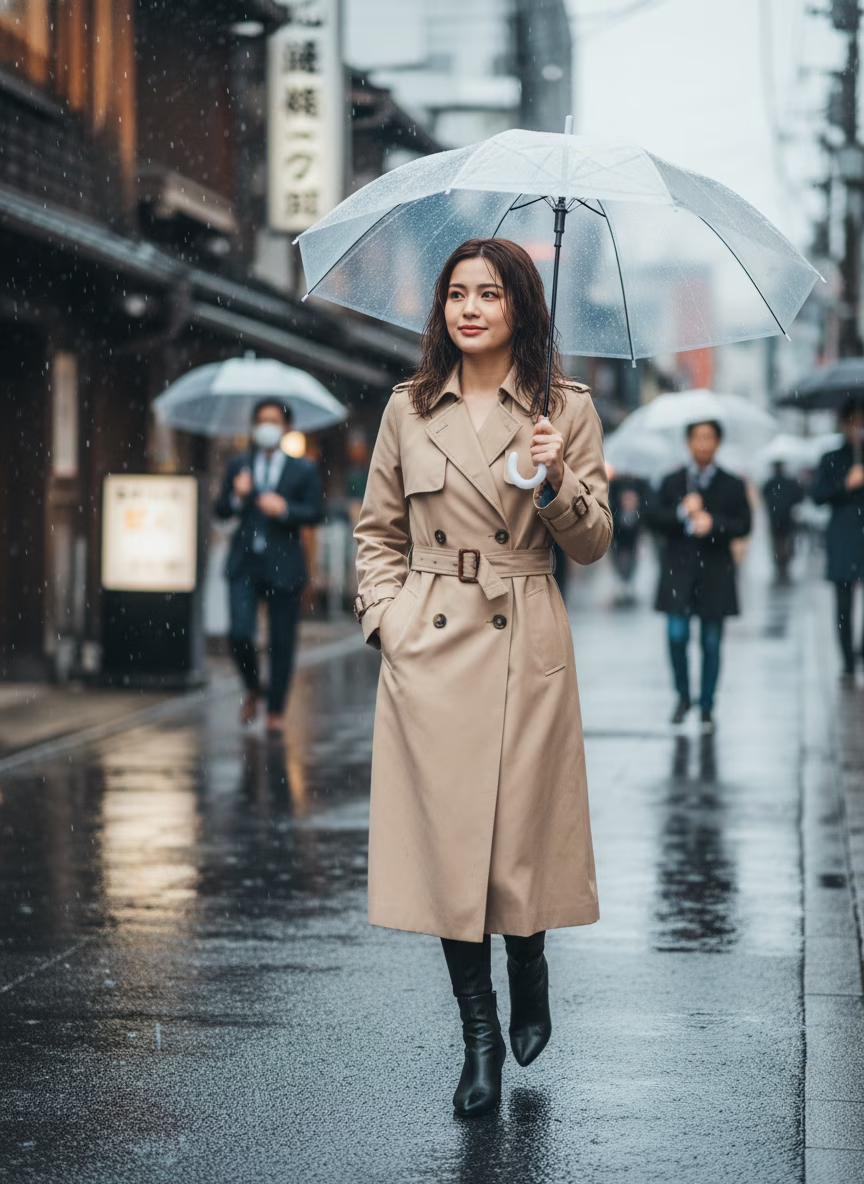


Γιατί το Z-Image Base Ξεχωρίζει για Απαιτητικούς Δημιουργούς & Developers
Ενώ το Z-Image Turbo κυριαρχεί στην παραγωγή 8 βημάτων κάτω του δευτερολέπτου, τα μοντέλα απόσταξης βημάτων συμπιέζουν τη λανθάνουσα ποικιλομορφία και δυσκολεύουν την εκπαίδευση LoRA. Η Alibaba Tongyi-MAI διέθεσε το μη αποσταγμένο checkpoint Z-Image Base (Tongyi-MAI/Z-Image) ειδικά για να ξεκλειδώσει πλήρη ποικιλία πολλαπλών βημάτων, λεπτομερή ρύθμιση Classifier-Free Guidance (CFG), καθοδήγηση με negative prompts και ομαλή σύγκλιση στο fine-tuning.
Μέγιστη Δημιουργική Ποικιλομορφία
Χωρίς το mode collapse της απόσταξης βημάτων, το Z-Image Base προσφέρει πολύ πλουσιότερη συνθετική ποικιλία ανά seed—ιδανικό για art direction, concept design και φωτογράφιση υψηλής μόδας.
Πλήρης Έλεγχος CFG & Negative Prompts
Υποστηρίζει κλασική δειγματοληψία πολλαπλών βημάτων (συνήθως 28–50 NFEs με CFG 3.5–5.0), επιτρέποντας στους καλλιτέχνες να σμιλεύουν τον φωτισμό, να κόβουν ατέλειες και να ρυθμίζουν με ακρίβεια το στυλ.
Φτιαγμένο για Εκπαίδευση LoRA & ControlNet
Επειδή οι κλίσεις (gradients) παραμένουν μη αποσταγμένες, η εκπαίδευση LoRA χαρακτήρων, προσαρμογέων προϊόντων και ControlNets στο 6B Z-Image Base συγκλίνει ταχύτερα και απαιτεί τη μισή VRAM από το 12B FLUX.1-dev.
Δίγλωσσο Σημασιολογικό Θεμέλιο
Μοιράζεται την ίδια ενιαία ροή αγγλικών και κινεζικών tokens κειμένου-εικόνας, δίνοντας τη δυνατότητα δημιουργίας εξειδικευμένων checkpoints για brand τυπογραφία, αρχιτεκτονική, anime και e-commerce.
Πότε να Επιλέξετε Z-Image Base έναντι Z-Image Turbo
Κατανοώντας πώς το Z-Image Base και το Z-Image Turbo αλληλοσυμπληρώνονται, κάθε στούντιο επιλέγει το κατάλληλο εργαλείο σε κάθε στάδιο παραγωγής.
Πώς να Κάνετε Prototyping Ροών Z-Image στο z-img.net
Συνδυάστε άμεσο cloud πειραματισμό με επαγγελματικό prompt engineering:
1. Συνδεθείτε στο Cloud Studio Σας
Μπείτε στο z-img.net από οποιονδήποτε browser και συνδεθείτε για δωρεάν αρχικά credits, δοκιμάζοντας prompts χωρίς να κατεβάσετε πρώτα 12 GB+ αρχείων safetensors.
2. Δοκιμάστε Prompts & Επιλεγμένα Πρότυπα
Φορτώστε έτοιμα πρότυπα πορτρέτου, αρχιτεκτονικής και αγγλικής/δίγλωσσης τυπογραφίας για να δείτε πώς ανταποκρίνεται το S3-DiT σε φακούς, φωτισμό και κείμενο σε εισαγωγικά.
3. Εξάγετε 4K Renders ή Κλιμακώστε Τοπικά
Κατεβάστε έτοιμα εικαστικά υψηλής ανάλυσης απευθείας από το cloud, ή ακολουθήστε τον οδηγό τοπικής εγκατάστασης για δικά σας Z-Image Base + LoRA pipelines.
Αρχιτεκτονικά Πλεονεκτήματα του Z-Image Base
Σχεδιασμένο από το Alibaba Tongyi Lab για open-source επεκτασιμότητα και εμπορική αξιοπιστία.
6B Single-Stream DiT (S3-DiT)
Συνενώνει tokens κειμένου, οπτικής σημασιολογίας και VAE σε μία ενιαία ροή transformer για μέγιστη αποδοτικότητα παραμέτρων.
Εγγενής Υποστήριξη Negative Prompts
Το πλήρες Classifier-Free Guidance σας επιτρέπει να απομακρύνετε με ακρίβεια ανεπιθύμητα στυλ, χρωματικές αποκλίσεις ή ανατομικά λάθη.
Μισό Αποτύπωμα Μνήμης από το FLUX.1-dev
6 δισεκατομμύρια παράμετροι αντί για 12 δισεκατομμύρια μειώνουν δραστικά την κατανάλωση VRAM και τον χρόνο εκπαίδευσης LoRA σε κάρτες 16 GB–24 GB.
Δίγλωσση Ευθυγράμμιση Tokens
Κορυφαία κατανόηση και ευκρινής απόδοση αγγλικής και κινεζικής τυπογραφίας για διεθνείς δημιουργικές ομάδες και εξαγωγικά brands.
Έτοιμο για ComfyUI & Diffusers
Υποστηρίζεται άμεσα σε Hugging Face Diffusers, ModelScope και στους τυπικούς κόμβους του ComfyUI.
Ευέλικτη Άδεια Apache 2.0
Σε αντίθεση με τα μη εμπορικά dev βάρη ανταγωνιστών, το Z-Image επιτρέπει απεριόριστο εμπορικό fine-tuning και παραγωγική διάθεση.
Τεχνικές Προδιαγραφές Z-Image Base
Κύρια χαρακτηριστικά του μη αποσταγμένου checkpoint Z-Image 6B.
6B Παράμετροι Μη Αποσταγμένο Θεμέλιο S3-DiT
28–50 Βήματα Ακρίβεια Πλήρους CFG Denoising
Apache 2.0 Έτοιμο για Εμπορική Χρήση & LoRA
Συχνές Ερωτήσεις για το Z-Image Base
Βασικές διαφορές ανάμεσα στα Z-Image Base, Z-Image Turbo και FLUX.1-dev.